SOLOPUP · MIT 开源 · v2.0.0-rc.5 公开预览版
中文配音,英文字幕
保留中文原声,让英语观众跟着原有表演和信息节奏,逐屏理解故事。
先校准原文,再对照翻译
先依据最终中文原声校准中文字幕,再逐屏翻译成英文。中英两轨与视频同时显示,便于一起核对含义、术语、英文自然度和时间。剧本只作参考,不能替代实际发音。
跟随中文断句与信息顺序
中文分两屏说完的句子,英文也优先拆成对应两屏。例如第一屏:“先别开门。”/“Don’t open the door yet.”;第二屏:“我听见外面有声音。”/“I hear something outside.”。这是说明信息顺序的编写示例,不是实测校时或模型质量证明。
兼顾长度、节奏与音节
在含义准确、英文自然的基础上,尽量贴近中文发音的长度、节奏和音节,不为凑数添加内容。音节估算与差值只供审校参考,既不是精确口型验证,也不强求每句音节完全相等才准导出。
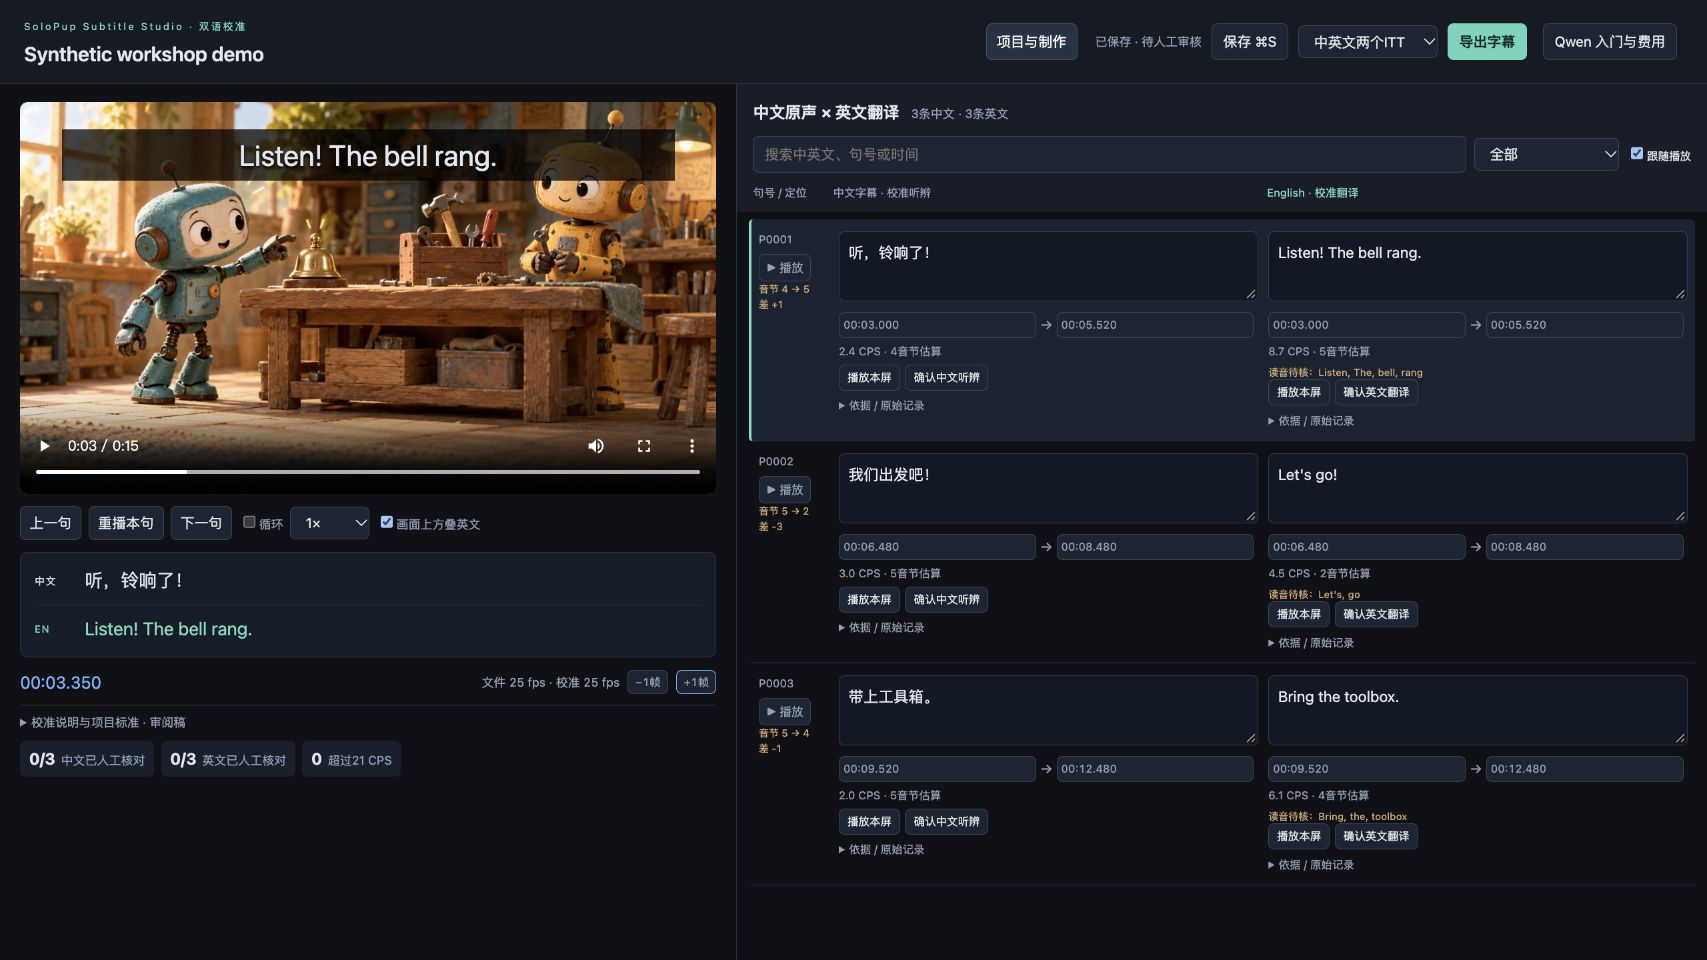
截图字幕为导入的示例文字,中英两轨均保留待人工审核。演示视频没有与这些字幕对应的对白,不能用于证明识别或翻译质量;只有场景画面由 AI 生成。
导入、审校与导出
- 新建中文配音双语项目。离线校对可导入本机视频及屏数、时码对应的中文和英文 SRT。
- 分别审校中文听辨和英文翻译,对照真实原声检查读速与时码。
- 保存审核决定。双语默认目标为 17 CPS,项目上限为 21 CPS;这不是所有儿童平台的统一规范。
- 沿用原视频文件名,分别导出 .zh 和 .en 的 ITT 或 SRT,放在对应视频旁供播放器识别。
当前支持范围
双语编辑页目前使用中文控件。自动生产目标为英语 US/UK;日文、韩文规范摘要不代表已经具备验证过的对应自动生产能力。云端翻译需要自己的 Qwen Key 与模型权限;可选的本地中文识别需要另装依赖和多语言模型。